
ネットワークは通常動作中は安定していますが、サイト全体の再起動後に一部のデバイスが再接続に失敗します。考えられる原因の一つは、正当な起動時のバーストよりも低い保護しきい値が設定されていることです。アイドル状態のネットワークでは保守的に見えるストーム制御設定が、復旧が最も重要な局面で障害を引き起こす可能性があります。
ストームコントロールは、プラットフォームの分類、測定、およびアクションルールに基づいて、選択されたトラフィックを制限します。同じ表示数値でも、インターフェースやデバイスによってレートが大きく異なる場合があります。まずはこれらのルールを理解し、次に観測されたアプリケーショントラフィックを使用してポリシーを選択し、テストしてください。
何が制限されているのかを正確に特定する
設定がブロードキャスト、マルチキャスト、不明なユニキャスト、またはその他の文書化されたカテゴリに適用されるかどうかを確認してください。既知のユニキャストと不明なユニキャストは同義語ではなく、マルチキャストにはアプリケーションに不可欠なトラフィックが含まれる場合があります。
各カテゴリが個別にカウントされるのか、まとめてカウントされるのか、また測定がどこで行われるのかを確認してください。他のベンダーの馴染みのあるメニューラベルが同じ範囲を指すと決めつけるのではなく、正確なモデルのドキュメントをお読みください。
シスコの暴風雨制御設定ガイドこの図は、トラフィッククラス、しきい値、および抑制動作の役割を示しています。設定と実装上の制限はプラットフォーム固有のものであるため、他のスイッチの既成設定としてではなく、概念的な参考資料として使用してください。
設定を比較する前に、しきい値の単位を翻訳してください。
しきい値がインターフェース帯域幅のパーセンテージで表される場合、インターフェース速度の名目上の意味が変わります。1 Gb/s の 1 パーセントは 10 Mb/s ですが、100 Mb/s の 1 パーセントは 1 Mb/s です。これらは計算上の例であり、実際のハードウェアにおける計測および適用粒度については、まだ確認が必要です。
パケット/秒のしきい値は、異なる量を測定します。例えば、1秒あたり1,000パケットの場合、100バイトのパケットはカウントされたバイト数のうち0.8 Mb/sを占め、1,000バイトのパケットは8 Mb/sを占めます。オンワイヤのオーバーヘッドとスイッチのカウント長の定義によって、この関係は変化する可能性があります。
その違いは、小さなパケットの制御ワークロードと大きなメディアパケットを比較する際に重要になります。別のポートからコピーされた設定は、両方のポートが同じ数値を表示している場合でも、実質的に異なる制限を課す可能性があります。
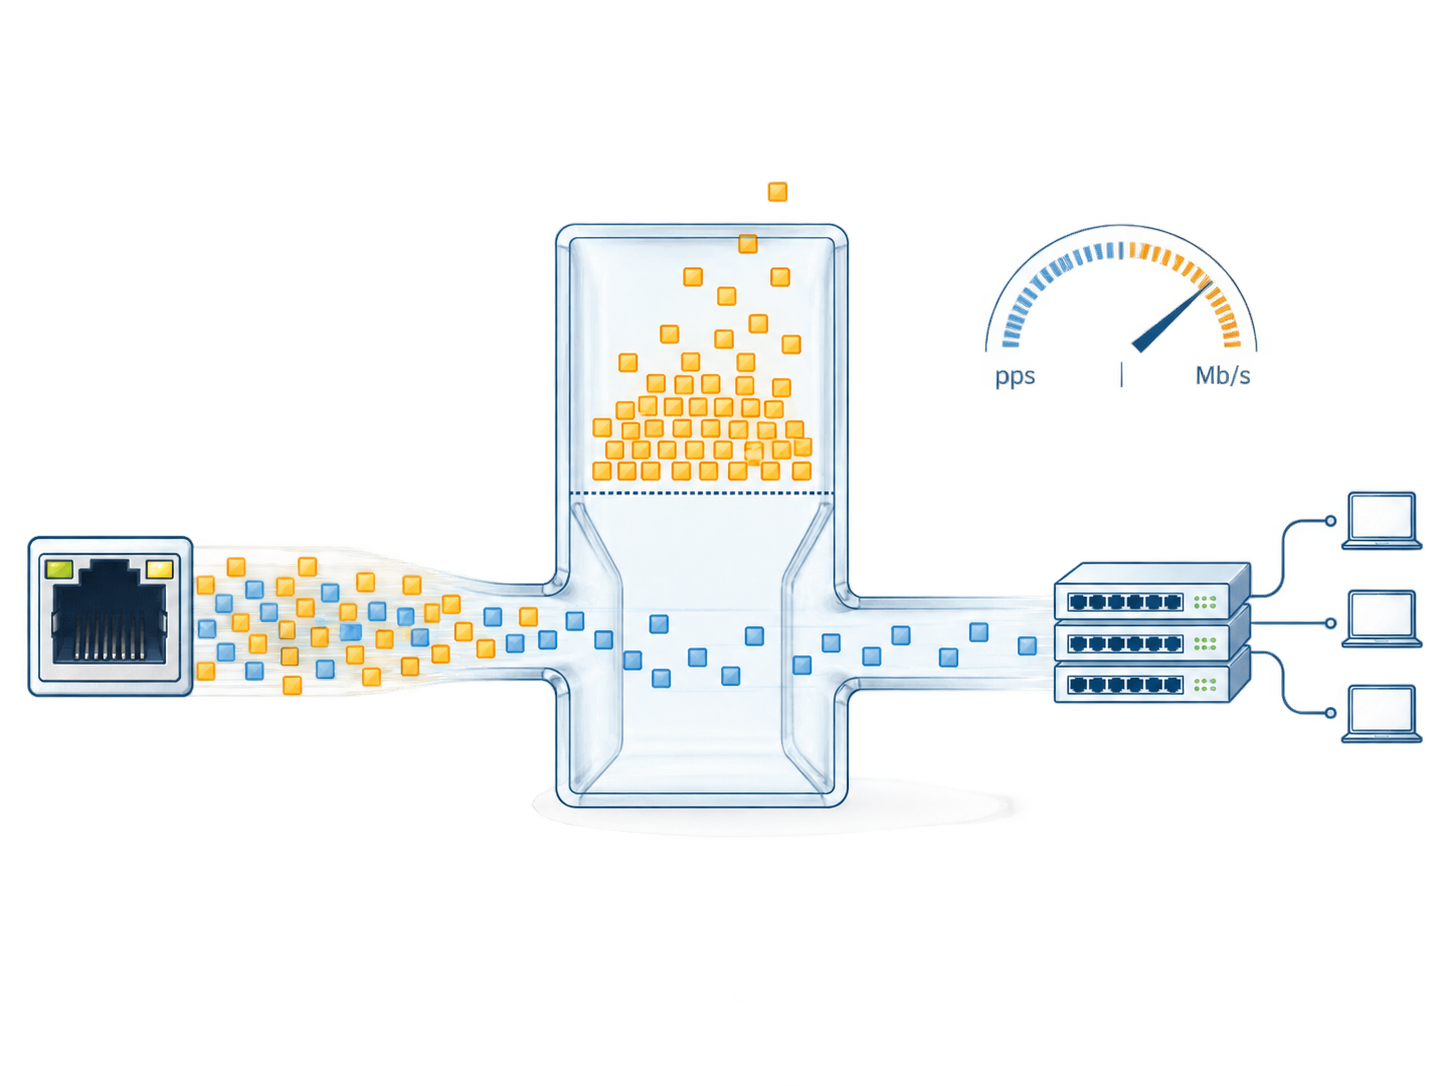
平均交通量だけでは制限を選択するには不十分です
起動、アドレス解決、検出、マルチキャスト参加、トポロジ変更、アプリケーション再接続など、正当なトラフィックバーストが発生する状態におけるネットワークを監視します。これらのイベントのうち、制御対象のトラフィッククラスに該当するものを特定します。
関連するパターンを明らかにできる測定間隔を使用してください。長い平均値は、スイッチの適用間隔では異なる扱いを受ける短いバーストを平滑化することができます。バースト許容値や丸め処理を含め、デバイスの間隔としきい値の動作が文書化されている場合は、それらを入手してください。
トラフィックの証拠は、構成とワークロードに関連付けて記録してください。接続デバイスが5台の場合のベースラインは、50台に拡張した後は自動的に適切とは限りません。ファームウェアのバージョンやアプリケーションモードの変更によって、検出および復旧の動作も変わる可能性があります。
しきい値と同じくらい慎重にアクションを選択してください。
実装によっては、イベントによって特定のトラフィックが抑制されたり、アラームが発報されたり、ポートが無効化されたり、あるいは複数のアクションが組み合わされたりする場合があります。これらの結果は、サービスに様々な影響を与えます。例えば、ポートのシャットダウンは、トリガーが特定のクラスに関するものであっても、そのポート上のすべてのトラフィックに影響を与える可能性があります。
イベント発生後に何が起こるべきかを定義してください。転送速度が規定のレベルを下回った場合、転送は復旧しますか?別途、低下しきい値はありますか?オペレーターは無効になったポートを復旧する必要がありますか?自動復旧が有効になっている場合、永続的な障害によって接続が繰り返し切り替わるのを防ぐものは何ですか?
採用されたポリシーは、これらの疑問に運用面で答えるものでなければなりません。誰も受け取らないアラームは、対応手順が定められた監視対象イベントと同じ保護効果を発揮しません。復旧方法が明確に定められていないシャットダウンポリシーは、本来抑制しようとしていた停止期間を長引かせる可能性があります。
役割に応じて港をレビューする
| ポートロール | 交通状況を理解する | 閾値審査に関する懸念 |
|---|---|---|
| 直接エンドポイント | 通常時、起動時、および故障時の動作 | 狭いベースラインでは、有効な回復バーストを見逃す可能性があります。 |
| ダウンストリームアクセススイッチ | 複数のエンドポイントからのトラフィックを集約する | コピーされたエンドポイントのしきい値は制限が厳しすぎる可能性がある |
| マルチキャスト受信パス | 必要なメディアグループと管理交換 | 必須マルチキャストは引き続き使用可能でなければならない |
| 冗長アップリンク | 経路変更前後の交通状況 | 生き残った道はより大きな荷物を運ぶことができる |
| 一時的なメンテナンス接続 | 想定されるツールと調査活動 | 短期作業は承認された港湾方針に従うべきである |
設計上の根拠がない限り、すべてのインターフェースに単一の普遍的な値を適用することは避けるべきです。数値的な均一性よりも、ポートの役割の一貫性の方が重要です。
健常例と異常例の両方を検証する
管理されたテスト環境で、正規のワークロードを起動から再接続まで実行します。必要なサービスが予期せぬ停止やシャットダウンなく正常に動作することを確認します。リンクが維持されているかどうかだけでなく、該当するカウンターやイベントも監視します。
次に、承認された異常トラフィック事例を、隔離された環境または適切に管理された環境で実施します。意図した措置と、影響を受けていないサービスへの影響を確認します。トラフィックの種類、レートパターン、タイミング、および復旧結果を記録します。
チェックボックスが機能するかどうかを確認するためだけに、本番ネットワークで意図的に負荷をかけるような行為は避けてください。テスト環境と注入方法は、サイトで承認されたプロセスに合致している必要があります。ポリシーを広く展開する前に、代表的なパイロットテストを実施することで、動作を確認することができます。
通常サービス中にしきい値を超えるイベントが発生した場合は、制限値を引き上げる前に、その発生源とパターンを調査してください。原因としては、正当な拡張、エンドポイントの設定ミス、または意図しないレイヤ2ループなどが考えられます。これらのケースでは、それぞれ異なる修正が必要です。
ループ防止と会員管理を徹底する
ストームコントロールは、ループのないトポロジーに取って代わるものではなく、あくまで補助的な保護手段です。ループが存在すると、特定のトラフィックが抑制された場合でも、障害が発生し続ける可能性があります。状況からループの存在が示唆される場合は、基となるケーブル配線やスパニングツリー、リングの設計を見直してください。
同様に、意図しないマルチキャスト配信が発生した場合は、メンバーシップとクエリーの調査が必要になる場合があります。マルチキャストのしきい値を厳しく設定すると、フラッディングを隠蔽できる一方で、ストリームを必要とする受信側にも悪影響を及ぼす可能性があります。転送設計を修正し、結果として生じるトラフィックに対してレートポリシーを検証してください。
目標は、異常な動作を抑制しつつ、本来のアプリケーションの動作を維持することです。そのためには、健全なネットワーク設計と、適切にテストされた保護対策の両方が必要です。
デプロイされた各値の理由を文書化してください。
のためにTODAHIKA マネージドスイッチの選択具体的なモデルについて、サポートされているトラフィッククラス、しきい値単位、測定動作、イベントの可視性、および復旧制御についてお問い合わせください。お問い合わせの際には、ポートの役割と重要な起動要件も併せてご提示ください。
選択した設定は、基準となる観測結果とテスト結果とともに保管してください。変更内容(エンドポイントの増加、新しいマルチキャストサービス、アップリンク速度の変更、またはリカバリシーケンスの改訂など)を明記してください。この記録により、次のエンジニアは、ネットワークに適合しなくなった可能性のある説明のつかない数値を引き継ぐのではなく、意図的にポリシーを調整することができます。
投稿日時:2026年9月1日


